جستجوی معنایی با pgvector در PostgreSQL؛ از نصب تا ایندکس HNSW
چرا جستجوی معنایی داخل PostgreSQL؟ #
وقتی صحبت از جستجوی معنایی و embedding میشود، خیلیها فوراً به سراغ دیتابیسهای برداری اختصاصی میروند. اما اگر دادههای اصلی شما همین حالا در PostgreSQL است، اضافه کردن یک سرویس جدید یعنی همگامسازی داده بین دو سیستم، دو نسخهٔ پشتیبان، دو مدل امنیتی و یک نقطهٔ شکست بیشتر.
pgvector یک افزونهٔ متنباز برای PostgreSQL است که نوع دادهٔ برداری، عملگرهای فاصله و ایندکسهای جستجوی تقریبی را مستقیماً به دیتابیس اضافه میکند. یعنی میتوانید بردارها را کنار دادههای معمولیتان نگه دارید و در یک کوئری SQL هم فیلتر معمولی بزنید، هم JOIN کنید و هم بر اساس شباهت معنایی مرتب کنید. طبق صفحهٔ پروژه، pgvector از جستجوی دقیق و تقریبی، فاصلههای L2، inner product، cosine، L1، Hamming و Jaccard پشتیبانی میکند و همهٔ مزایای Postgres مثل ACID، بازیابی point-in-time و JOIN را حفظ میکند.
نصب و راهاندازی #
سادهترین راه استفاده از ایمیج Docker آماده است:
docker run -d --name pg-vector \
    -e POSTGRES_PASSWORD=secret \
    -p 5432:5432 \
    pgvector/pgvector:pg18
روی سیستمعاملهای لینوکسی معمولاً بستهٔ آماده هم وجود دارد (مثلاً postgresql-18-pgvector در مخزن PGDG). بعد از نصب، افزونه را در هر دیتابیسی که لازم دارید فعال کنید:
CREATE EXTENSION IF NOT EXISTS vector;
یادداشت
نام افزونه در SQL vector است، نه pgvector. این یکی از رایجترین اشتباههای اولین استفاده است.
نوع دادهٔ vector #
بعد از فعالسازی، یک نوع دادهٔ جدید به نام vector(n) دارید که n تعداد ابعاد است:
CREATE TABLE articles (
    id          bigserial PRIMARY KEY,
    title       text NOT NULL,
    body        text NOT NULL,
    category    text,
    published   boolean DEFAULT true,
    embedding   vector(1536)
);
تعداد ابعاد باید دقیقاً با خروجی مدل embedding شما برابر باشد. اگر مدل شما بردار ۱۰۲۴ بُعدی تولید میکند، ستون را vector(1024) تعریف کنید.
درج داده با یک رشتهٔ ساده انجام میشود:
INSERT INTO articles (title, body, embedding)
VALUES ('سلام', 'متن نمونه', '[0.12, -0.03, 0.88, ...]');
عملگرهای فاصله #
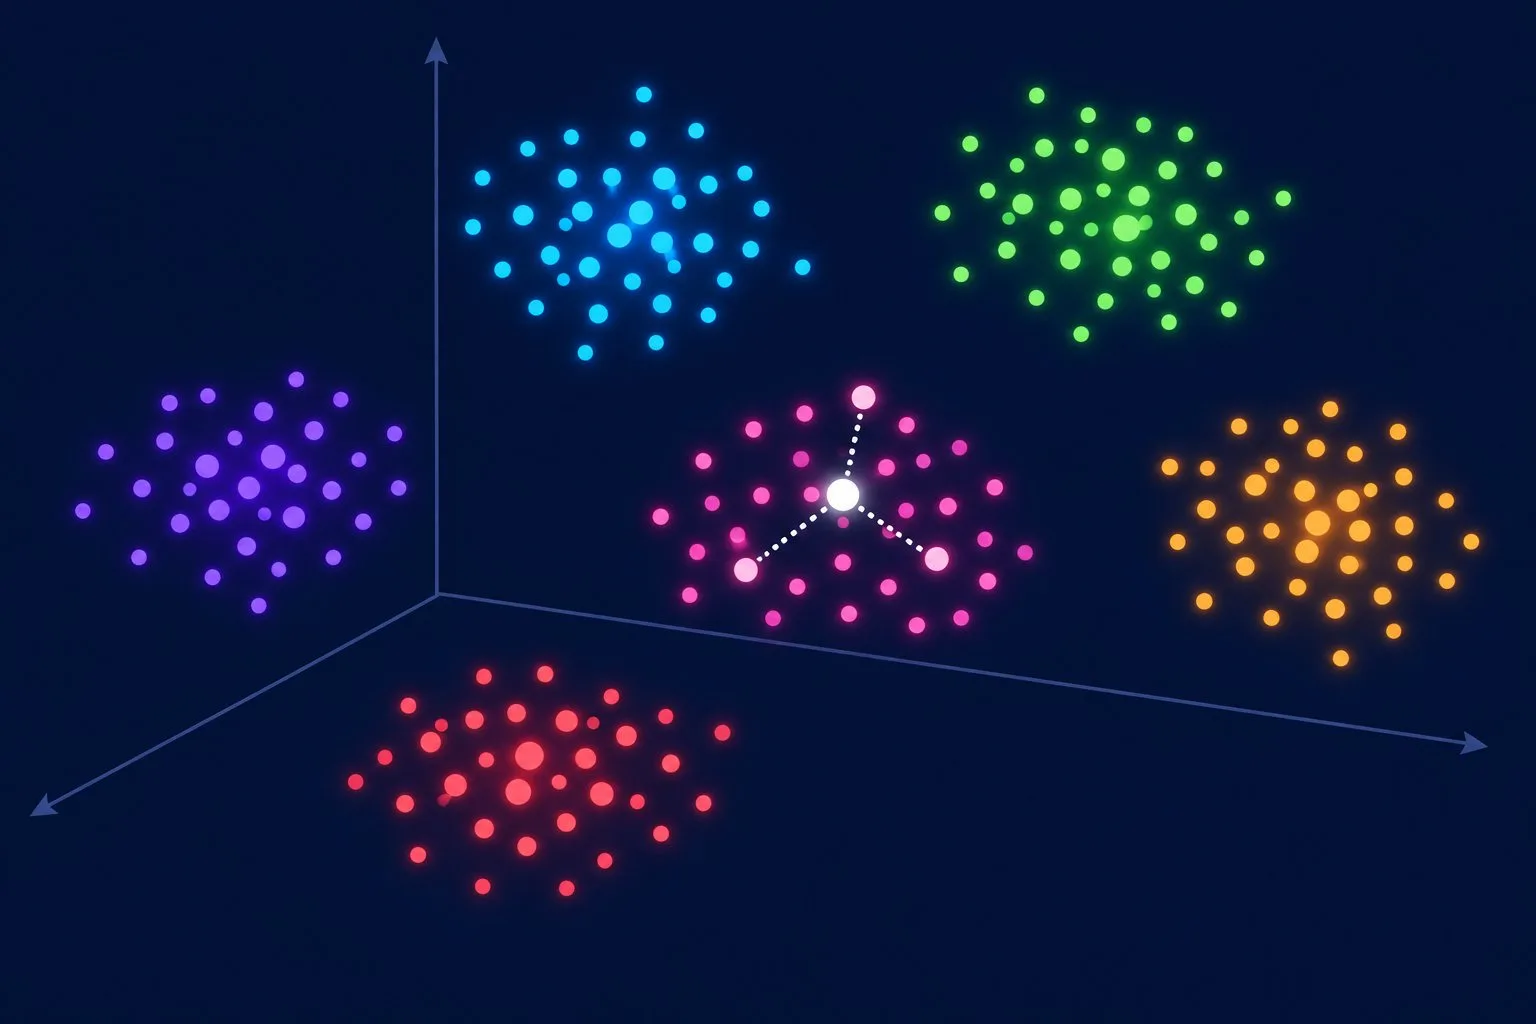
pgvector چند عملگر فاصله دارد که باید با معیار مدل embedding خود هماهنگ کنید:
| عملگر | معیار | کلاس عملگر ایندکس |
|---|---|---|
<-> |
فاصلهٔ اقلیدسی (L2) | vector_l2_ops |
<#> |
ضرب داخلی منفی | vector_ip_ops |
<=> |
فاصلهٔ کسینوسی | vector_cosine_ops |
<+> |
فاصلهٔ L1 (منهتن) | vector_l1_ops |
یک کوئری جستجوی ساده:
SELECT id, title, embedding <=> '[0.11, -0.02, 0.91, ...]' AS distance
FROM articles
ORDER BY embedding <=> '[0.11, -0.02, 0.91, ...]'
LIMIT 5;
نکته
عملگر <#> ضرب داخلی را منفی برمیگرداند، چون Postgres فقط از اسکن ایندکس با ترتیب صعودی پشتیبانی میکند. برای گرفتن شباهت واقعی آن را در -1 ضرب کنید. برای cosine هم شباهت برابر 1 - (a <=> b) است.
اگر بردارهای مدل شما نرمالشده هستند (طول ۱ دارند)، که در بیشتر مدلهای embedding مدرن اینطور است، inner product سریعترین گزینه است و نتیجهای معادل cosine میدهد.
ایندکسگذاری: HNSW یا IVFFlat #
بدون ایندکس، pgvector جستجوی دقیق انجام میدهد؛ یعنی فاصلهٔ بردار پرسش را با تکتک ردیفها حساب میکند. این برای چند ده هزار ردیف قابل قبول است، اما برای میلیونها ردیف کند میشود. اینجا ایندکسهای تقریبی (Approximate Nearest Neighbor) وارد میشوند که کمی دقت (recall) را با سرعت بسیار بیشتر معاوضه میکنند.
HNSW #
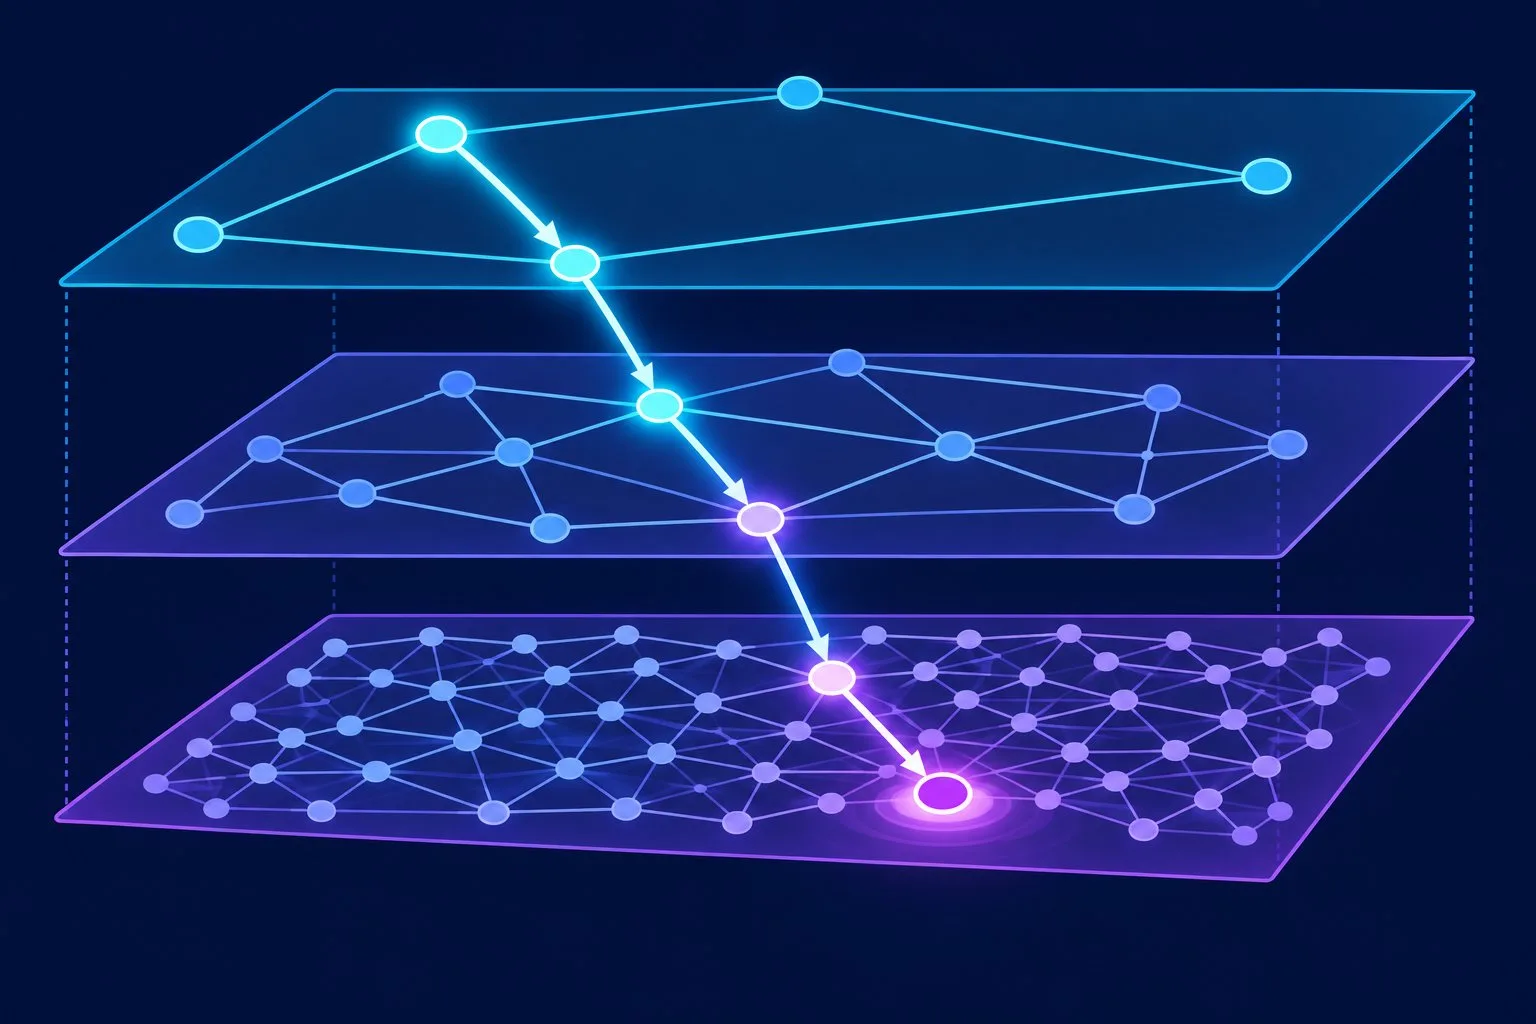
HNSW یک گراف چندلایه میسازد که جستجو از لایههای بالایی (با یالهای بلند) شروع شده و به لایههای پایینتر (با جزئیات بیشتر) میرسد:
CREATE INDEX ON articles USING hnsw (embedding vector_cosine_ops);
پارامترهای ساخت:
CREATE INDEX ON articles USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);
m: حداکثر تعداد اتصال هر گره در هر لایه (پیشفرض ۱۶).ef_construction: اندازهٔ لیست کاندیدها هنگام ساخت گراف (پیشفرض ۶۴). عدد بالاتر یعنی گراف باکیفیتتر اما ساخت کندتر.
و پارامتر زمان جستجو:
SET hnsw.ef_search = 100;
مقدار پیشفرض ef_search برابر ۴۰ است. افزایش آن recall را بالا میبرد و جستجو را کمی کندتر میکند. میتوانید آن را فقط برای یک تراکنش تنظیم کنید:
BEGIN;
SET LOCAL hnsw.ef_search = 200;
SELECT ... ;
COMMIT;
IVFFlat #
IVFFlat بردارها را به تعدادی خوشه (list) تقسیم میکند و هنگام جستجو فقط چند خوشهٔ نزدیک را بررسی میکند:
CREATE INDEX ON articles USING ivfflat (embedding vector_cosine_ops)
WITH (lists = 100);

SET ivfflat.probes = 10;
مهم
ایندکس IVFFlat را بعد از پر کردن جدول بسازید. این ایندکس خوشهها را بر اساس دادههای موجود تعیین میکند و ساختن آن روی جدول خالی نتیجهٔ بدی میدهد. HNSW چنین محدودیتی ندارد.
| معیار | HNSW | IVFFlat |
|---|---|---|
| سرعت جستجو و recall | بهتر | متوسط |
| زمان ساخت | کندتر | سریعتر |
| مصرف حافظه | بیشتر | کمتر |
| ساخت روی جدول خالی | مشکلی ندارد | توصیه نمیشود |
برای بیشتر پروژهها HNSW انتخاب پیشفرض خوبی است.
محدودیت ابعاد و halfvec #
طبق مستندات pgvector، ایندکسگذاری روی نوع vector تا ۲۰۰۰ بُعد پشتیبانی میشود. اگر مدل شما بردار بزرگتری تولید میکند، میتوانید از نوع halfvec (اعداد اعشاری نیمدقت) استفاده کنید که تا ۴۰۰۰ بُعد قابل ایندکس است و نصف فضا را هم میگیرد:
CREATE INDEX ON articles
USING hnsw ((embedding::halfvec(3072)) halfvec_cosine_ops);

SELECT id, title FROM articles
ORDER BY embedding::halfvec(3072) <=> '[...]'::halfvec(3072)
LIMIT 5;
پیادهسازی با پایتون #
کتابخانهٔ pgvector برای پایتون، آداپتورهای psycopg، SQLAlchemy و Django را فراهم میکند:
uv add "psycopg[binary]" pgvector numpy
import numpy as np
import psycopg
from pgvector.psycopg import register_vector

conn = psycopg.connect("postgresql://postgres:secret@localhost/postgres", autocommit=True)
conn.execute("CREATE EXTENSION IF NOT EXISTS vector")
register_vector(conn)

def add_article(title: str, body: str, embedding: np.ndarray):
    conn.execute(
        "INSERT INTO articles (title, body, embedding) VALUES (%s, %s, %s)",
        (title, body, embedding),
    )

def semantic_search(query_vec: np.ndarray, category: str | None = None, k: int = 5):
    sql = """
        SELECT id, title, 1 - (embedding <=> %(q)s) AS similarity
        FROM articles
        WHERE published AND (%(cat)s::text IS NULL OR category = %(cat)s)
        ORDER BY embedding <=> %(q)s
        LIMIT %(k)s
    """
    return conn.execute(sql, {"q": query_vec, "cat": category, "k": k}).fetchall()
در Django #
from django.db import models
from pgvector.django import VectorField, HnswIndex, CosineDistance

class Article(models.Model):
    title = models.CharField(max_length=200)
    body = models.TextField()
    embedding = VectorField(dimensions=1536)

    class Meta:
        indexes = [
            HnswIndex(
                name="article_embedding_hnsw",
                fields=["embedding"],
                m=16,
                ef_construction=64,
                opclasses=["vector_cosine_ops"],
            )
        ]

# جستجو
# Article.objects.order_by(CosineDistance("embedding", query_vec))[:5]
برای فعالسازی افزونه در Django یک مایگریشن با VectorExtension() از pgvector.django بسازید.
فیلتر و ایندکس تقریبی: یک دام رایج #
وقتی WHERE را با ORDER BY ... LIMIT روی ایندکس تقریبی ترکیب میکنید، Postgres ابتدا از ایندکس نزدیکترین کاندیدها را میگیرد و سپس فیلتر را اعمال میکند. اگر فیلتر شما بیشتر ردیفها را حذف کند، ممکن است کمتر از تعداد درخواستی نتیجه بگیرید.
راهحلها:
- برای فیلترهای پرکاربرد با تعداد مقادیر کم، ایندکس جزئی (partial index) بسازید:
CREATE INDEX ... WHERE category = 'news'. ef_searchرا بالا ببرید.- از قابلیت iterative index scan در نسخههای جدید pgvector استفاده کنید که در صورت کم بودن نتایج، اسکن ایندکس را ادامه میدهد (
SET hnsw.iterative_scan = relaxed_order;). - همیشه با
EXPLAIN ANALYZEبررسی کنید که ایندکس واقعاً استفاده میشود. اگر با این دستور آشنا نیستید، راهنمای EXPLAIN ANALYZE در PostgreSQL را بخوانید.
چکلیست راهاندازی در production #
- ابعاد ستون با مدل embedding یکسان است.
- کلاس عملگر ایندکس با عملگر کوئری هماهنگ است (
vector_cosine_opsبا<=>). -
maintenance_work_memبرای ساخت سریعتر HNSW بهاندازهٔ کافی بزرگ است. - ساخت ایندکس روی جدول بزرگ با
CREATE INDEX CONCURRENTLYانجام میشود. -
ef_searchبا یک مجموعهٔ ارزیابی recall تنظیم شده است. - برای ستونهای بسیار بزرگ استفاده از
halfvecبررسی شده است.
آیا pgvector برای میلیونها بردار مناسب است؟
بله، با ایندکس HNSW و حافظهٔ کافی، میلیونها بردار در یک سرور قابل مدیریت است. برای مقیاسهای بسیار بزرگتر، partitioning یا sharding (مثلاً با Citus) هم پشتیبانی میشود.
آیا میتوانم جستجوی متنی و برداری را ترکیب کنم؟
بله. میتوانید نتایج full-text search خود Postgres (tsvector) را با نتایج برداری با روشی مثل Reciprocal Rank Fusion ترکیب کنید و یک جستجوی ترکیبی (hybrid) داشته باشید.
جمعبندی #
pgvector به شما اجازه میدهد جستجوی معنایی و پایههای یک سیستم RAG را بدون اضافه کردن زیرساخت جدید، داخل همان PostgreSQL آشنا بسازید. با انتخاب درست عملگر فاصله، ایندکس HNSW و تنظیم ef_search، به عملکردی میرسید که برای اکثر محصولات کافی است. اگر هنوز با مفهوم RAG آشنا نیستید، مطلب RAG چیست را بخوانید.