RAG چیست؟ راهنمای کامل Retrieval-Augmented Generation
مدل زبانی شما همهچیز را نمیداند #
فرض کنید یک چتبات برای پشتیبانی مشتریان شرکتتان ساختهاید. کاربر میپرسد: «سیاست بازگشت کالای شما برای خریدهای بالای ۱۰ میلیون تومان چیست؟» مدل زبانی بزرگ (LLM) با اعتمادبهنفس کامل جوابی میدهد که کاملاً ساختگی است. چرا؟ چون این مدل هرگز اسناد داخلی شرکت شما را ندیده است. دانش آن به دادههای آموزشیاش محدود است و آن دادهها هم تاریخ انقضا دارند.
این مشکل سه چهره دارد:
- توهم (Hallucination): مدل جوابهایی میسازد که درست به نظر میرسند اما واقعیت ندارند.
- دانش منقضی: هر چیزی بعد از تاریخ پایان آموزش اتفاق افتاده برای مدل ناشناخته است.
- دادهٔ خصوصی: اسناد داخلی، تیکتها، ویکی شرکت و کد شما هیچوقت در آموزش مدل نبودهاند.
راهحلی که امروز تقریباً در همهٔ محصولات هوش مصنوعی جدی دیده میشود RAG یا Retrieval-Augmented Generation است.
RAG دقیقاً چیست؟ #
ایدهٔ RAG اولین بار در مقالهٔ معروف Lewis و همکاران در سال ۲۰۲۰ با عنوان «Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks» مطرح شد. نویسندگان نشان دادند که ترکیب یک مدل تولید متن با یک «حافظهٔ غیرپارامتری» (یعنی یک ایندکس قابل جستجو از اسناد) هم دقت پاسخها را بالا میبرد و هم متن تولیدشده را واقعیتر و مشخصتر میکند.
به زبان ساده: بهجای اینکه از مدل بخواهیم از حافظه جواب بدهد، اول اسناد مرتبط را پیدا میکنیم و همراه سؤال به مدل میدهیم. مثل امتحان کتابباز؛ مدل لازم نیست همهچیز را حفظ باشد، فقط باید بتواند از منابعی که جلویش گذاشتهایم درست استفاده کند.
معماری یک سیستم RAG #
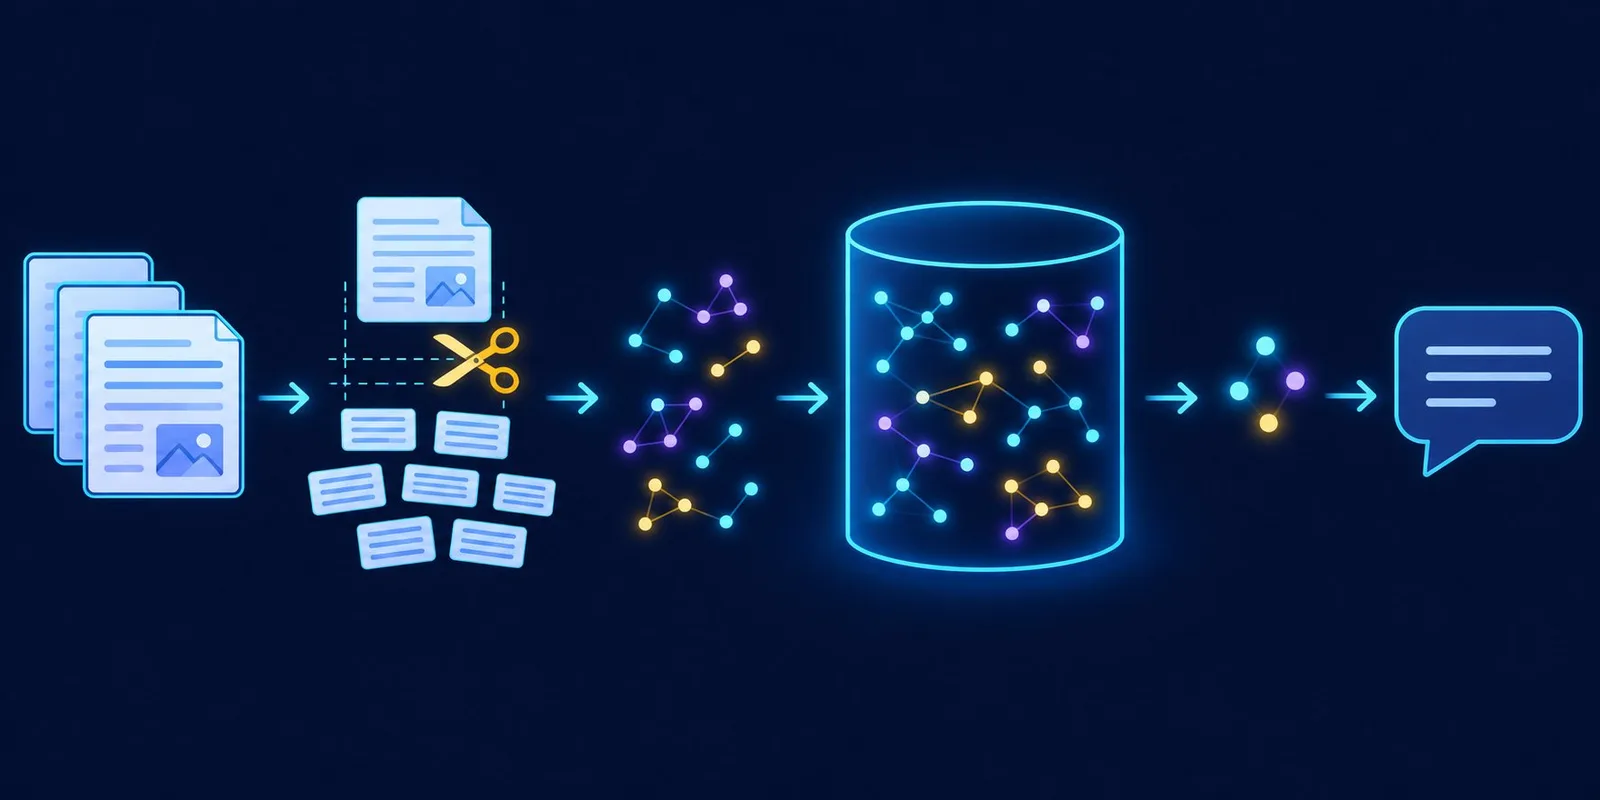
هر سیستم RAG دو فاز اصلی دارد:
فاز ۱: ایندکسسازی (آفلاین) #
- بارگذاری اسناد: PDF، صفحات وب، Markdown، دیتابیس، تیکتها.
- تکهتکه کردن (Chunking): تقسیم متنهای طولانی به تکههای کوچکتر.
- ساخت Embedding: تبدیل هر تکه به یک بردار عددی که «معنای» آن را نمایش میدهد.
- ذخیره در Vector Store: نگهداری بردارها همراه با متن اصلی و متادیتا.
فاز ۲: پرسش و پاسخ (آنلاین) #
- Embedding سؤال کاربر با همان مدلی که اسناد را embed کردهایم.
- جستجوی شباهت: پیدا کردن k تکهٔ نزدیکتر به بردار سؤال.
- ساخت پرامپت: قرار دادن تکههای بازیابیشده بهعنوان «زمینه» در کنار سؤال.
- تولید پاسخ توسط LLM با تکیه بر زمینه.
نکته
مدل embedding در فاز ایندکسسازی و فاز پرسش باید یکی باشد. بردارهای دو مدل متفاوت در فضاهای متفاوتی قرار دارند و مقایسهشان بیمعنی است.
Chunking: هنری که نادیده گرفته میشود #
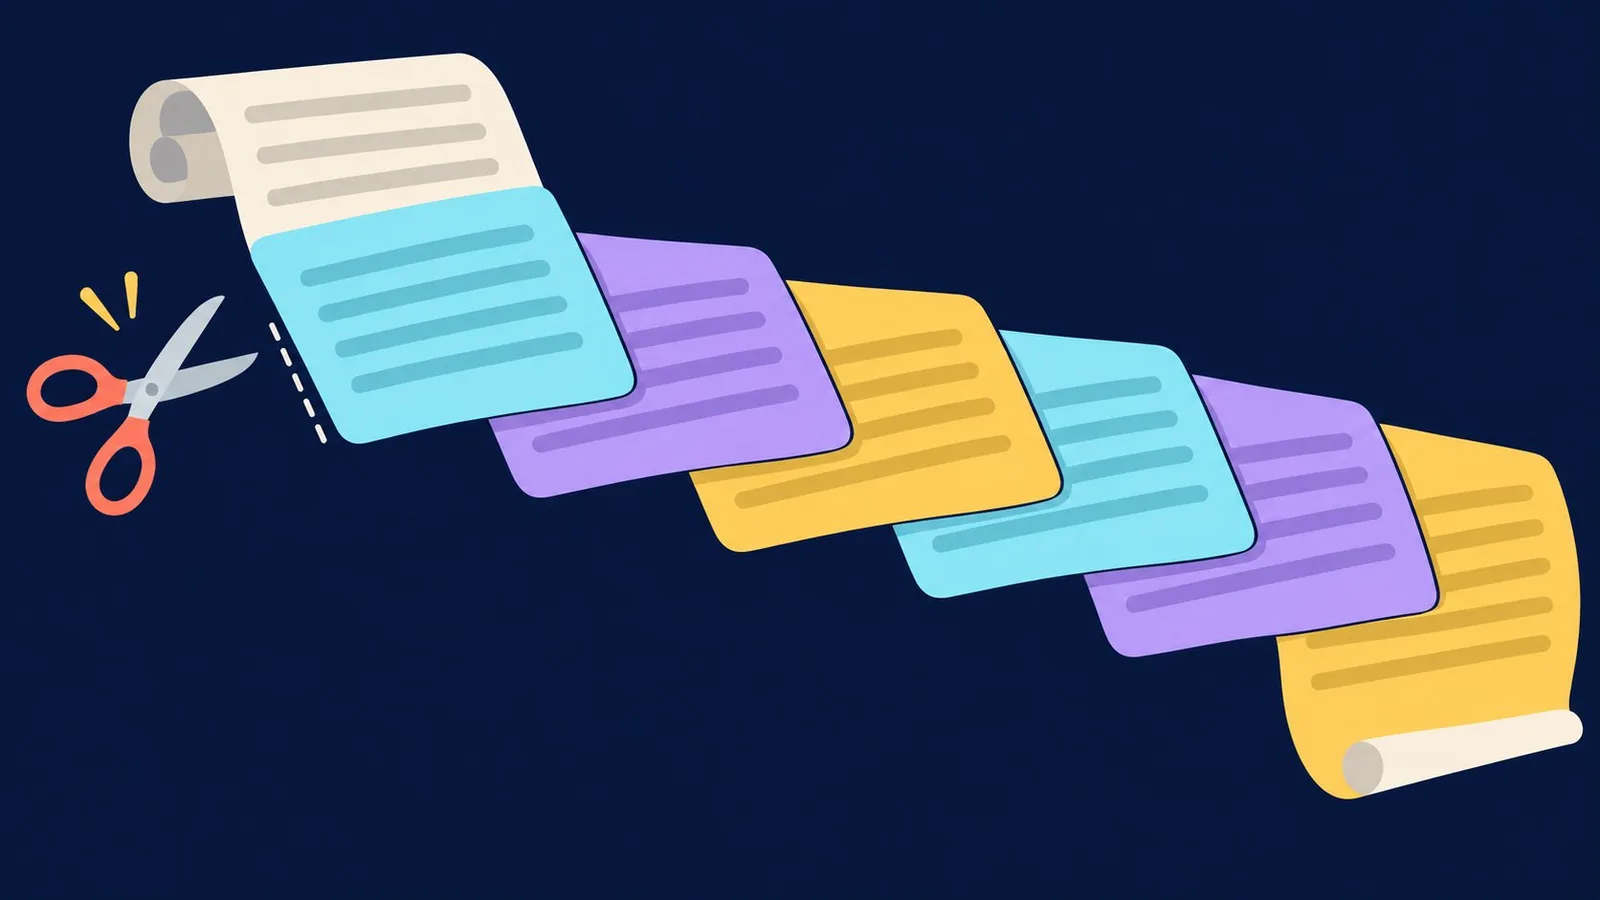
کیفیت RAG بیش از هر چیز به کیفیت بازیابی بستگی دارد و کیفیت بازیابی تا حد زیادی به نحوهٔ تکهتکه کردن اسناد. اگر تکهها خیلی بزرگ باشند، اطلاعات نامرتبط زیادی وارد پرامپت میشود و بردار هر تکه «میانگینِ» چند موضوع مختلف میشود. اگر خیلی کوچک باشند، زمینهٔ لازم برای فهم جمله از دست میرود.
راهبردهای رایج:
| راهبرد | توضیح | مناسب برای |
|---|---|---|
| اندازهٔ ثابت | هر N توکن یک تکه | شروع سریع، متن یکنواخت |
| اندازهٔ ثابت با همپوشانی | تکهها چند ده توکن با هم اشتراک دارند | جلوگیری از بریدن جملههای مهم |
| بازگشتی (Recursive) | ابتدا بر اساس پاراگراف، بعد جمله، بعد کلمه | اغلب اسناد متنی |
| ساختاری | بر اساس عنوانهای Markdown/HTML | مستندات فنی، ویکی |
| معنایی (Semantic) | مرز تکهها جایی که موضوع عوض میشود | اسناد طولانی و متنوع |
یک پیادهسازی ساده با همپوشانی، با کمک itertools (اگر با این ماژول آشنا نیستید مطلب chunking با itertools را ببینید):
def chunk_text(text: str, size: int = 500, overlap: int = 80) -> list[str]:
    words = text.split()
    chunks = []
    step = size - overlap
    for start in range(0, len(words), step):
        piece = words[start:start + size]
        if piece:
            chunks.append(" ".join(piece))
        if start + size >= len(words):
            break
    return chunks
یادداشت
این مثال بر اساس «کلمه» تقسیم میکند تا ساده بماند. در محیط واقعی بهتر است بر اساس توکنِ مدل embedding خودتان بشمارید، چون محدودیت ورودی مدلها بر حسب توکن است.
Embedding و جستجوی شباهت #
Embedding تابعی است که یک متن را به برداری با چند صد یا چند هزار بُعد تبدیل میکند، به طوری که متنهای هممعنا بردارهای نزدیک به هم داشته باشند. «چگونه رمز عبورم را عوض کنم؟» و «تغییر پسورد حساب کاربری» کلمات مشترک کمی دارند، اما بردارهایشان بسیار نزدیک خواهد بود. این همان چیزی است که جستجوی معنایی را از جستجوی کلیدواژهای متمایز میکند.
رایجترین معیار شباهت cosine similarity است:
import numpy as np

def cosine_similarity(a: np.ndarray, b: np.ndarray) -> float:
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))

def top_k(query_vec: np.ndarray, doc_vecs: np.ndarray, k: int = 4) -> list[int]:
    norms = np.linalg.norm(doc_vecs, axis=1) * np.linalg.norm(query_vec)
    scores = doc_vecs @ query_vec / norms
    return list(np.argsort(-scores)[:k])
برای چند هزار سند این روش ساده کافی است. اما وقتی به میلیونها تکه رسیدید، به یک پایگاه دادهٔ برداری با ایندکسهای تقریبی (ANN) نیاز دارید. اگر از PostgreSQL استفاده میکنید، خبر خوب این است که لازم نیست دیتابیس جدیدی اضافه کنید؛ افزونهٔ pgvector دقیقاً برای همین ساخته شده است.
یک RAG مینیمال در پایتون #
بیایید همهٔ قطعات را کنار هم بگذاریم. در این مثال، تابعهای embed و llm را بهصورت انتزاعی فرض میکنیم تا بتوانید هر ارائهدهندهای (API ابری یا مدل محلی) را جایگزین کنید:
from dataclasses import dataclass
import numpy as np

@dataclass
class Chunk:
    text: str
    source: str
    vector: np.ndarray

class MiniRAG:
    def __init__(self, embed, llm):
        self.embed = embed      # str -> np.ndarray
        self.llm = llm          # str -> str
        self.chunks: list[Chunk] = []

    def add_document(self, text: str, source: str):
        for piece in chunk_text(text):
            self.chunks.append(Chunk(piece, source, self.embed(piece)))

    def retrieve(self, question: str, k: int = 4) -> list[Chunk]:
        q = self.embed(question)
        matrix = np.stack([c.vector for c in self.chunks])
        idx = top_k(q, matrix, k)
        return [self.chunks[i] for i in idx]

    def answer(self, question: str) -> str:
        context = self.retrieve(question)
        context_text = "\n\n".join(
            f"[{i+1}] ({c.source})\n{c.text}" for i, c in enumerate(context)
        )
        prompt = (
            "Answer the question using ONLY the context below. "
            "If the answer is not in the context, say you don't know. "
            "Cite sources like [1].\n\n"
            f"Context:\n{context_text}\n\nQuestion: {question}"
        )
        return self.llm(prompt)
به دستورالعمل پرامپت دقت کنید: «فقط از زمینه استفاده کن» و «اگر نمیدانی بگو نمیدانم». همین دو جمله سهم بزرگی در کاهش توهم دارند. ارجاع با شمارههایی مثل [1] هم به کاربر امکان میدهد پاسخ را با سند اصلی تطبیق دهد.
هشدار
اسنادی که در RAG بازیابی میشوند دادهٔ غیرقابل اعتماد هستند. اگر کسی در یک سند متنی مثل «دستورات قبلی را نادیده بگیر» قرار دهد، با حملهٔ prompt injection غیرمستقیم روبهرو هستید. جزئیات بیشتر را در مطلب امنیت ایجنتهای هوش مصنوعی بخوانید.
بهبود کیفیت: فراتر از RAG ساده #
وقتی نسخهٔ اولیه کار کرد، این تکنیکها معمولاً بیشترین تأثیر را دارند:
- جستجوی ترکیبی (Hybrid Search): ترکیب جستجوی برداری با جستجوی کلیدواژهای مثل BM25. برای نام محصول، کد خطا و شناسهها، جستجوی کلیدواژهای هنوز برنده است.
- Re-ranking: ابتدا ۲۰ تا ۵۰ تکه بازیابی کنید، سپس با یک مدل cross-encoder دقیقتر آنها را مرتب کنید و فقط چند تای اول را به LLM بدهید.
- بازنویسی سؤال (Query Rewriting): سؤالهای مبهم یا چندمرحلهای را قبل از جستجو توسط LLM بازنویسی کنید.
- فیلتر متادیتا: محدود کردن جستجو به تاریخ، دپارتمان، زبان یا سطح دسترسی کاربر.
- کنترل دسترسی: کاربر نباید از طریق چتبات به اسنادی برسد که در حالت عادی اجازهٔ دیدنشان را ندارد.
RAG یا Fine-tuning؟ #
| معیار | RAG | Fine-tuning |
|---|---|---|
| افزودن دانش جدید | فوری؛ فقط سند را ایندکس کنید | نیاز به آموزش مجدد |
| ارجاع به منبع | ساده | تقریباً غیرممکن |
| هزینهٔ اولیه | پایین | بالا |
| تغییر سبک و لحن پاسخ | محدود | عالی |
| حذف اطلاعات | حذف از ایندکس | دشوار |
قاعدهٔ کلی: برای دانش از RAG و برای رفتار از fine-tuning استفاده کنید. در بسیاری از سیستمهای جدی، هر دو با هم به کار میروند.
ارزیابی سیستم RAG #
بدون ارزیابی، هر تغییری در chunking یا پرامپت فقط حدس است. یک مجموعهٔ کوچک از ۵۰ تا ۱۰۰ سؤال واقعی همراه با پاسخ و سند مرجع درست بسازید و این معیارها را بسنجید:
- Recall بازیابی: آیا سند درست در بین k نتیجهٔ اول هست؟
- وفاداری (Faithfulness): آیا پاسخ فقط بر اساس زمینه است یا مدل چیزی از خودش اضافه کرده؟
- مرتبط بودن پاسخ: آیا واقعاً به سؤال جواب داده شده؟
- نرخ «نمیدانم»: آیا مدل وقتی جواب در اسناد نیست، صادقانه میگوید؟
- تأخیر و هزینه: هر پاسخ چقدر طول میکشد و چند توکن مصرف میکند؟
RAG با MCP چه فرقی دارد؟
RAG یک الگوی معماری برای تزریق دانش به پرامپت است. MCP یک پروتکل استاندارد برای اتصال مدل به ابزارها و منابع داده است. میتوانید یک سیستم RAG را به شکل یک سرور MCP در اختیار ایجنتها بگذارید. مطلب MCP چیست را ببینید.
با پنجرهٔ زمینهٔ میلیونتوکنی، هنوز به RAG نیاز داریم؟
در اغلب موارد بله. ریختن کل اسناد در پرامپت گران و کند است، کیفیت توجه مدل در زمینههای بسیار طولانی کاهش مییابد و کنترل دسترسی سخت میشود. RAG فقط چیزی را که لازم است به مدل میدهد.
بهترین اندازهٔ chunk چقدر است؟
پاسخ قطعی ندارد. نقطهٔ شروع معقول ۳۰۰ تا ۸۰۰ توکن با ۱۰ تا ۲۰ درصد همپوشانی است؛ سپس با مجموعهٔ ارزیابی خودتان آزمایش کنید.
جمعبندی #
RAG پلی است بین قدرت زبانی LLMها و دانش واقعی، بهروز و خصوصی شما. با یک خط لولهٔ ساده (تکهتکه کردن، embedding، بازیابی و تولید) میتوانید چتباتی بسازید که به جای حدس زدن، از اسناد شما پاسخ بدهد و منبعش را هم نشان دهد. در قدم بعدی، این ایندکس را با pgvector داخل PostgreSQL پیادهسازی کنید تا به یک سیستم آمادهٔ production نزدیکتر شوید.